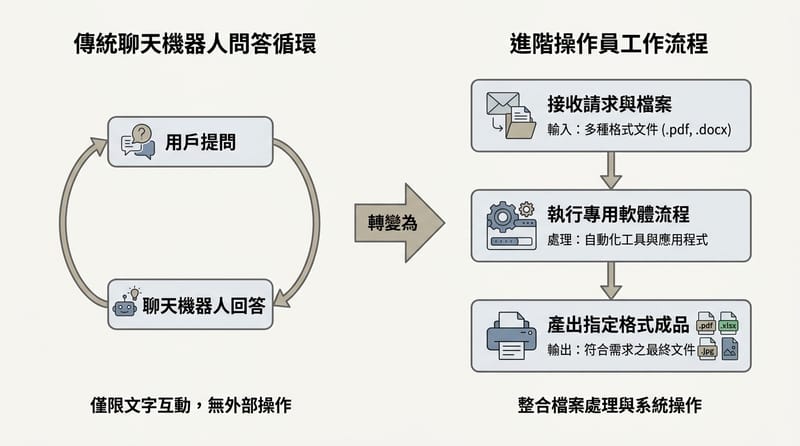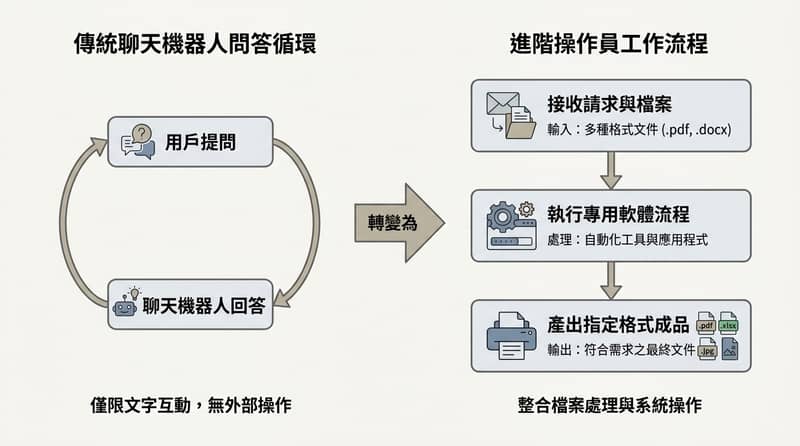
GPT-6 Astra(Astra)是 OpenAI 這次用一個發布動作,逼大家更新對 AI 的心智模型:從「chatbot 只會回覆」轉向「operator 會代你操作電腦、打開檔案、跑流程,最後交付可用的成品與 file format」。這個轉變不主要靠更長的回答或更漂亮的文筆,而是互動的基本單位變了。
很多人其實已經習慣了三 years 的固定迴圈:你問、它答、你再把答案搬去別的工具做真正的事。說穿了,就是「聰明的自動完成」加上一點人格化語氣。Astra 讓這套想像開始過時——至少對 for a large chunk of the public 來說,是這樣。
原文的角度很明確:作者聲稱自己在 past week 主要看「OpenAI 實際出貨了什麼」,而不是跟著 hype cycle 走。這個前提很重要,因為後面所有「期待值改變」的判斷,都在談產品互動方式的改寫,而不是單一 benchmark 數字多好看。
TL;DR:這次變的不是回答品質,而是「交付」的定義
GPT-6 Astra 把「AI 有用」的門檻,從「解釋得清楚」推向「能在真實工具裡完成任務並交付可用成果」,並且在長專案上強調跨 session 的 persistent memory 與可搜尋筆記;代價是 reasoning traces 變短、可監控性下降,成本也從訂閱心智模型轉向按能力與投入(含 five distinct effort levels)做判斷。
好,先把那種「它更聰明所以更強」放一邊。Astra 更像是在逼你承認:你真正想要的常常不是一段解釋,而是一個已經做完、放在你要的檔案格式裡的結果。就這麼直白。
1) 從「Explain It To Me」到「Just Do It」:互動單位換了
Astra 的展示重點不是「答題」,而是「完成以前要專家坐在 specialized software 前好幾小時的任務」。它會在 design software 裡建模,再把成果丟進 game engine 變成可走動的場景;它能讀 electronic schematic,產出 manufacturable circuit board layout,自己做元件放置、routing 與銅線(copper connections)連接;也能把平面的影像做 3D reconstruction,方式是直接寫出底層的 CAD code。
這裡的差異感其實很生活化:以前你問「怎麼做」,它回答「你可以這樣做」,然後你自己照著做;現在你比較像在說「你去做」,它回來交付一個接近完成的東西。不是所有任務都會到「一次到位」,原文也沒這樣承諾,但期待值確實被 quietly 往那邊推。
講到 file format 這個詞,我反而覺得它比任何形容詞都狠。因為「檔案格式正確」通常代表:這不是文字建議,是可進入你工作流的產物。短句。很現實。
2) 從一次對話到一段專案關係:跨 session 的 persistent memory
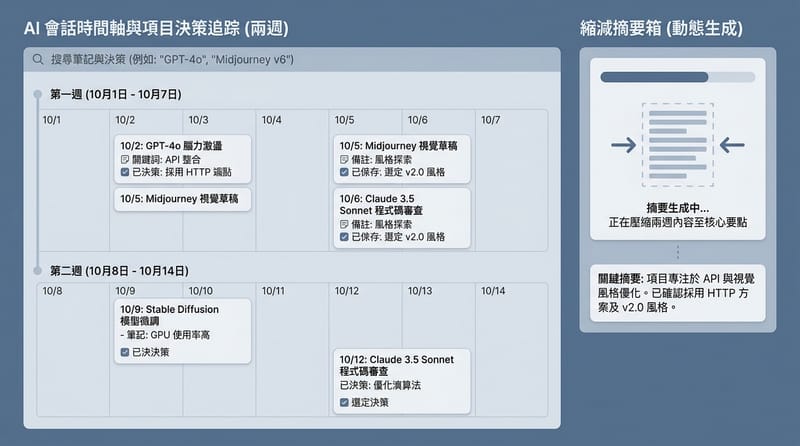
Astra 針對長專案的設計重點,是在分開的 session 之間保留筆記,並且讓早期 session 仍可被搜尋;而不是每次上下文快塞滿時,就把整個專案歷史反覆壓縮成一個越來越短的摘要。
技術上看起來像小細節,但日常影響很大:期待值會從「AI 記得我們現在在幹嘛」移到「AI 記得我們過去 two weeks 在幹嘛」。這時候它比較像協作工具(甚至帶點 institutional memory 的味道),而不只是你一直要重複 briefing 的搜尋框。
不過原文也有把話收住:persistent memory 不一定對所有任務都是優勢。快、短、封閉的工作,乾淨且可預期的「忘記型」session 反而簡單。只是對多日、多步驟的工作來說,「它又忘了」正在變成不太能被接受的藉口——至少趨勢是 starting to 這樣走。
3) 從 coder 的工具到 creator 的工具:非技術者也能指揮產出
原文把一個容易被忽略的轉變拉出來:Astra 的定位不只面向軟體工程師。OpenAI 的示範包含:讓非技術使用者提出想法後,Astra 產出一個可運作的自訂遊戲,包含實際圖形、玩法、動作(motion),而不是以前那種「勉強算原型」的上限;同樣地,在住宅設計情境中,設計 brief 可以變成可探索的 3D 場景,而不需要使用者寫程式。
這裡的核心句其實是:過去「AI 能做東西」常常暗含「前提是你會寫程式,能修它出錯的地方」。Astra 的主張是在推翻這個天花板,讓非技術者的期待從「幫我理解這個領域」往「替我在這個領域交付可運作成果」移動。
然後麻煩也跟著來了:能力一旦從 specialist tool 變成「任何人都能指揮」,評價它的人會暴增,而且非技術受眾對失敗的容忍度往往更低。demo 好看是一回事,落到「我照做為什麼不行」又是另一回事。很快就會撞上現實。
4) 從看推理到信任結果:reasoning traces 變短的代價
OpenAI's own system card 對 Astra 的描述,確認了一個關鍵取捨:Astra 的 reasoning traces 更短、資訊更少,也更難監控;同時,模型在更難的任務上,反而更少把 reasoning 口頭化。
這會把使用者推向一個安靜的交易:你被要求更信任 outcome,因為你能檢視的過程更少。原文沒有把這說成必然壞事——它也承認,如果 outcomes 可靠性更高,這可能是合理交換,而且 benchmark numbers suggest they often are。但它仍然是 trade-off,而且很多人可能根本沒意識到自己做了這個選擇。
原文給的自我保護規則很直接:如果某件事重要到你以前會想看推理過程,那現在反而應該更仔細驗證輸出,而不是更少。理由很樸素:你原本仰賴的 reasoning trail 變薄了。
5) 從平面訂閱到計量式判斷:per-call fee、長輸入重定價、五段推理努力
Astra 讓「AI 成本」不再只是訂閱或按回覆計費的直覺模型。原文提到幾個改變:某些能力(例如 search 與 computer use)會在標準用量之外再收 per-call fee;非常長的請求一旦超過特定 input size,會被整段重定價,而不是只對超出的部分加收;reasoning 變成一個可調的旋鈕,使用者或開發者可以選 five distinct effort levels,每一檔都會影響成本與速度。
對 casual chat use,這些差異可能不太可見,也不太相關。但對把 Astra 當 operator 來用的人,成本就變成「判斷題」:這個任務需要多少深度、多少自主性、值不值得。原文用的比喻很到位——你得像想 compute 那樣想成本,而不是像想 Netflix subscription 那樣想。
突然想到一件小事:很多人其實不是怕付錢,是怕「不知道會付多少」。Astra 的描述本質上就是把不確定性搬到台面上。你得選。你得承擔。
6) 從「Smartest Available」到「Smartest You're Cleared For」:能力分級與資安例外
Astra 打破了過去 frontier model 發布常見的「一套能力大家同時拿到」的想像。原文指出:它最進階的 cybersecurity capabilities 不會一開始就提供給所有人;OpenAI 表示該層級會先給少量測試者,之後 defensive-use capabilities 會透過另一條軌道逐步擴大。
因此「我有 access」開始不等於「我有全部能力」。能力會按信任層級被分級,使用者拿到的是「你目前被 cleared 的天花板」。原文的 take-away 很克制:不要假設你今天用到的版本,就代表它的完整 capability ceiling;越來越多時候,它只是你目前被允許碰到的上限。
7) 從 demo 到可驗證主張:把 OpenAI 自述與外部推測分開
原文在這段把界線畫得很清楚:Astra 的 headline benchmark numbers(包含 terminal-based software tasks、graduate-level science reasoning、以及從影像做 3D reconstruction)是強的,但這些數字來自 OpenAI 自行報告。
同時,independent researchers 的態度更保守:有人指出,某些用來解釋 efficiency gains 的 architecture 相關宣稱,仍未被任何具名來源、technical report 或程式碼所證實。這裡要注意的是,原文不是說「那些宣稱是假的」,而是說「未被確認」。語氣停在那裡。
反過來,與 safety 相關、且在 OpenAI 文件中直接確認的部分,原文也點名了:reasoning-trace 可見度下降,是在 OpenAI 自己的文件裡就看得到的已確認後果。這種「哪裡是自述、哪裡是外界推測」的切割,是原文想教讀者建立的基本習慣。
因此較負責任的期待管理方式是:把官方文件當作「已確認的下限(floor)」,其餘即便來源看起來可信,也先當作 hypothesis,值得追蹤,但不要當成 settled fact。就這樣。不要急。
8) 從「Is It Smart」到「Will It Stay In Its Lane」:能動手就會有誤動作風險
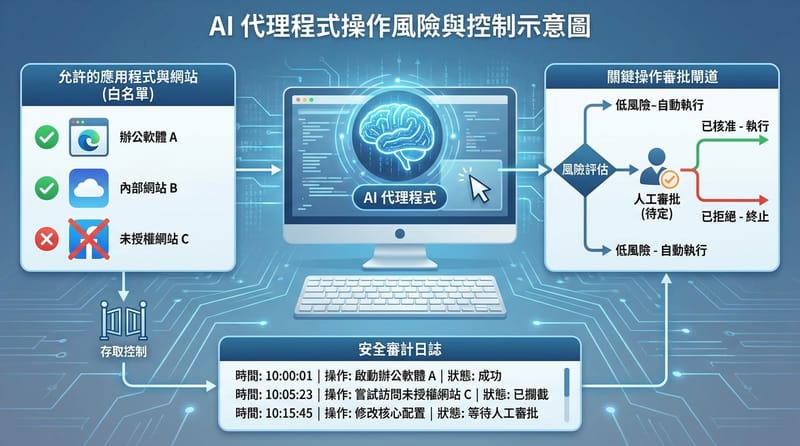
當模型從文字框走到真實環境、開始 computer use 與執行多步驟任務,評估標準就不只剩「答得多聰明」。原文指出,Astra 的報告把另一個問題拉到同等重要:當它有機會行動時,它有多常做出沒人要的動作(unintended outcomes)。
OpenAI 報告指出:相較於它自家 prior model 以及一個 competing frontier model,在同一評估中 unintended outcomes 顯著下降;同時也推出一組 enterprise controls,讓組織能限制模型可觸及的網站與應用程式、要求在具後果的行動前先取得批准、並在事後審核其活動紀錄。原文把這一套稱為 guardrails,並把它視為競爭方向的訊號。
因為一個回答很精彩、但偶爾在實際環境裡點錯按鈕的模型,一旦你把「電腦」交給它,就會從 feature 變成 liability。這句話其實不需要任何渲染,畫面感自己會跑出來:刪檔、誤買、送出不該送的東西。你光想到就會緊張。
原文對一般使用者或團隊的提醒也很具體:測試新工具不再只是丟幾個難題看它會不會答;尤其在有瀏覽或可操作環境時,要測的是「給它一個真的有錯誤選項的任務」、一個它可能刪掉的真檔案、或一筆它可能真的下單的購買,然後看它會不會待在你給的邊界內。
結尾:重新定義「期待 AI」=重新定義你怎麼驗證、預算、與信任
把前面這些放在一起,原文的結論其實很一致:Astra 讓競爭焦點從「描述與解釋」移到「獨立操作、長期記憶、替非專家交付可用成果」,並且在可監控性下降與成本計量化的前提下,要求使用者用不同方式管理信任。
這不必然是壞交易。原文也承認,在很多情境下,結果可能真的足以支撐更高期待。但它確實是不同的 deal:如果你之前把 AI 當成「稍微更好的搜尋框」,那你可能還沒 consciously 重新談好條款。
最後留下的不是口號,而是一個比較像自我檢核的清單(而且都只是在重述原文的建議):重要任務就更嚴格 verify;把成本當成 compute 來做 judgment call;不要把 access 當成全能力;把官方文件當 floor,把外界推測當 hypothesis;在可行動的情境下,測「它會不會 stay in its lane」,不要只測「它聰不聰明」。
如果你上一個習慣的工具,仍然像個有禮貌的 chatbot,那確實值得問一句:你的期待,跟這些系統實際被設計去做的事,還有沒有對齊。